Formação ao vivo, conduzida por instrutores, em PySpark, disponível online ou presencial, demonstra, através de práticas hands-on, como utilizar Python e Spark em conjunto para analisar big data.
A formação em PySpark está disponível como "formação ao vivo online" ou "formação ao vivo presencial". A formação ao vivo online (também conhecida como "formação ao vivo remota") é realizada através de um desktop remoto interativo. A formação ao vivo presencial pode ser realizada localmente nas instalações do cliente em Gaia ou nos centros de formação corporativa da NobleProg em Gaia.
NobleProg -- O seu fornecedor de formação local
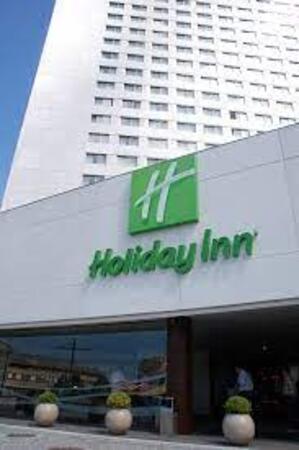
Holiday Inn Porto - Gaia
220, Rua Diogo Macedo, 220, Vila Nova de Gaia 4400-107 , Gaia, Portugal
Do Porto de Metro
Se vier do centro do Porto:
Apanhe a Linha D do Metro (linha amarela) em direção a Vila d’Este.
Saia na estação João de Deus.
A partir de João de Deus, caminhe cerca de 13 minutos até: Rua Diogo Macedo 220, 4400-107 Vila Nova de Gaia.
Da Estação de Comboios de Vila Nova de Gaia
Se por “estação de comboios local” se refere à Vila Nova de Gaia-Devesas:
A morada fica a aproximadamente 12 minutos a pé da estação Vila Nova de Gaia-Devesas, de acordo com as informações sobre a localização do alojamento.
Pode, portanto, ir diretamente a pé até ao alojamento, sem necessidade de apanhar o metro.
Esta formação ao vivo, conduzida por um instrutor, em Gaia, aborda a plataforma Stratio, com foco nos módulos Rocket e Intelligence com PySpark. Os participantes dominarão a ingestão, transformação e análise avançada de dados, adquirindo competências práticas em ciclos de iteração, UDFs e fluxos de trabalho de dados empresariais.
Nesta formação ao vivo dirigida por um instrutor em Gaia, os participantes aprenderão a utilizar o Python e o Spark em conjunto para analisar big data, enquanto trabalham em exercícios práticos.
Ao final desta formação, os participantes serão capazes de:
Aprender a utilizar o Spark com o Python para analisar Big Data.
Trabalhar em exercícios que imitam casos do mundo real.
Utilizar diferentes ferramentas e técnicas para análise de big data utilizando o PySpark.
Esta formação ao vivo, orientada por um instrutor (online ou presencial), destina-se a engenheiros de dados, analistas de dados e profissionais de dados que desejem utilizar o Databricks e o PySpark para construir pipelines de dados escaláveis e migrar workflows SQL existentes.
Esta formação oferece uma introdução prática à criação de pipelines escaláveis de processamento de dados e de Machine Learning utilizando PySpark. Os participantes aprendem como o Apache Spark opera nos ecossistemas de Big Data modernos e como processar eficientemente grandes conjuntos de dados utilizando os princípios da computação distribuída.
Este curso prático de três dias foca-se na construção e otimização de cargas de trabalho de processamento de dados eficientes utilizando PySpark, Pandas e Polars em ambientes baseados em Kubernetes.
Os participantes desenvolverão uma compreensão prática de como as aplicações Spark são executadas no Kubernetes e de como as decisões de configuração a nível de aplicação influenciam o desempenho, a escalabilidade, o consumo de recursos e os custos. O curso abrange áreas-chave de otimização, incluindo o dimensionamento dos executores, a alocação de memória, a alocação dinâmica, as estratégias de particionamento, o comportamento do shuffle, os problemas de ficheiros pequenos e o processamento eficiente de Parquet.
O curso também aborda desafios comuns ao trabalhar com Pandas, incluindo limitações de memória e falhas por falta de memória, e apresenta o Polars como uma alternativa de alto desempenho para cargas de trabalho de processamento de dados selecionadas. Através de exercícios práticos, os participantes diagnosticarão problemas de desempenho e de memória, compararão diferentes estratégias de configuração e aplicarão técnicas de otimização a cenários realistas de ETL e machine learning.
O enfoque ao longo do curso é o tomada de decisão prática: compreender como identificar gargalos, selecionar a ferramenta adequada, configurar o Spark de forma eficiente e equilibrar o desempenho com o consumo de recursos de infraestrutura e os custos.
Leia mais...
Última Atualização:
Testemunhos de Clientes (2)
Apresentando diferentes maneiras de otimizar nossas consultas do PySpark.
Ivan Abrashev - UBB + DZI (KBC GROUP)
Curso - Efficient Data Processing on Kubernetes with PySpark, Pandas & Polars
Máquina Traduzida
Gostei do fato de ser prático. Adorei aplicar o conhecimento teórico com exemplos práticos.
Cursos de formação de PySpark em Gaia, Cursos ao fim de semana de PySpark em Gaia, Formação em horário laboral de PySpark em Gaia, PySpark guiado por instrutor em Gaia, Formação individual de PySpark em Gaia, PySpark nas instalações do cliente em Gaia, Aulas de PySpark em Gaia, Cursos em horário laboral de PySpark em Gaia,Coaching de PySpark em Gaia, PySpark guiado por instrutor em Gaia, Cursos privados de PySpark em Gaia, Formação de PySpark de fim de semana em Gaia, Formação em grupo de PySpark em Gaia, !Instrutor de PySpark em Gaia, Formador de PySpark em Gaia